Crawl budget - jak nim zarządzać, by nie marnować potencjału strony?
Czy wiesz, że roboty Google nie przeglądają Twojej strony bez końca? Każda witryna ma ograniczony limit zasobów, jakie wyszukiwarka przeznacza na jej skanowanie. Jeśli więc nie zadbasz o odpowiednią strukturę, najważniejsze sekcje serwisu mogą zostać pominięte. Jak tego uniknąć? Dowiedz się, jak zarządzać tym procesem, by w pełni wykorzystać potencjał swojej witryny w wynikach wyszukiwania.
Definicja crawl budget – co to właściwie jest?
Crawl budget to nic innego jak ilość zasobów (czasu, mocy obliczeniowej i przepustowości), które Googlebot decyduje się przeznaczyć na odwiedzenie i pobranie danych z konkretnej domeny w określonym przedziale czasowym.
Co to oznacza w praktyce? Jeśli posiadasz tysiące podstron, a bot „odwiedza” tylko sto z nich dziennie, to wprowadzone przez Ciebie zmiany w ofercie lub nowe wpisy blogowe mogą czekać tygodniami na zaindeksowanie. Efektywne zarządzanie tym budżetem sprawia, że robot trafia dokładnie tam, gdzie znajdują się treści przynoszące Twojej firmie zysk.
Czym jest crawl budget w praktyce algorytmu?
Aby podejść do tematu profesjonalnie, należy rozbić to pojęcie na dwa składowe elementy, o których oficjalnie wspomina dokumentacja Google dla deweloperów.
1. Limit szybkości indeksowania (Crawl Rate Limit)
Google stara się nie obciążać nadmiernie serwerów, na których znajdują się witryny. Jeśli więc Twój działa wolno lub zwraca błędy przy próbie połączenia, robot automatycznie ograniczy liczbę odwiedzin, by nie doprowadzić do zawieszenia się strony.
2. Zapotrzebowanie na indeksowanie (Crawl Demand)
Boty analizują, czy treści na Twojej domenie są popularne, a także jak często ulegają aktualizacji. Strony, które nie generują zainteresowania użytkowników lub od miesięcy nie były modyfikowane, będą odwiedzane znacznie rzadziej.
Synergia tych dwóch czynników tworzy ostateczny budżet, decydujący o tym, jak szybko Twoja witryna reaguje na zmiany w wynikach wyszukiwania. Właśnie dlatego tak ważne jest zrozumienie, czym jest crawl budget i co to oznacza dla długofalowej strategii widoczności.
Dlaczego optymalizacja budżetu indeksowania jest kluczowa?
W przypadku małych witryn-wizytówek, posiadających kilka lub kilkanaście podstron, budżet indeksowania zazwyczaj nie stanowi problemu. Google z łatwością przeskanuje cały serwis w kilka minut. Sytuacja zmienia się drastycznie w przypadku rozbudowanych portali informacyjnych oraz sklepów internetowych. Posiadając tysiące produktów, wariantów kolorystycznych czy filtrów, ryzykujesz, że bot utknie w tzw. pułapkach indeksowania.
Brak kontroli nad tym procesem prowadzi do sytuacji, w której np. najważniejsze kategorie, generujące najwyższą sprzedaż, pozostają nieodświeżone w wynikach wyszukiwania, podczas gdy robot traci czas na skanowanie regulaminów, polityki prywatności lub nieaktualnych wyników filtrowania. Optymalizacja w tym obszarze pozwala więc skierować uwagę algorytmu na priorytetowe sekcje witryny, co bezpośrednio przekłada się na lepsze wyniki w ramach działań crawl budget SEO.
Czynniki marnotrawiące potencjał Twojej strony
Zanim dowiesz się, jak optymalizować crawl budget, musisz zidentyfikować elementy, które go niepotrzebnie zużywają. Najczęstsze problemy to:
- duplikacja treści – generowanie wielu adresów URL z tą samą zawartością zmusza robota do wielokrotnego pobierania tych samych danych;
- błędy 404 i zbyt długie łańcuchy przekierowań 301 – każda próba wejścia bota na niedziałający link to strata części budżetu;
- tzw. thin content – czyli podstrony, które nie wnoszą nic nowego dla użytkownika (np. puste strony tagów czy archiwa dat), a ich obecność w strukturze powoduje, że robot musi poświęcić czas na ich „zrozumienie”, zamiast skupić się na wartościowych artykułach czy opisach produktów.
Jak optymalizować crawl budget – konkretne kroki techniczne
Proces optymalizacji należy zacząć od technicznych fundamentów. Pierwszym krokiem jest odpowiednia konfiguracja pliku robots.txt. To instrukcja dla crawlerów, które sekcje mogą odwiedzać, a jakie mają omijać. Poprzez zablokowanie dostępu do paneli logowania, koszyka czy skryptów wewnętrznych, oszczędzasz zasoby na indeksowanie treści merytorycznych.
Drugim niezwykle ważny element stanowi mapa witryny, czyli plik sitemap.xml. Powinien on zawierać wyłącznie linki do stron, które faktycznie chcesz wyświetlać w wynikach wyszukiwania. Usunięcie z mapy adresów przekierowujących lub nieaktualnych to jeden z najprostszych sposobów na to, by wskazać botowi właściwy kierunek.
Dodatkowo warto zadbać o strukturę linkowania wewnętrznego – domeny, do których prowadzi wiele linków z różnych sekcji serwisu, są dla Google’a sygnałem priorytetu i będą odwiedzane częściej.
Szybkość serwera a budżet indeksowania
Wydajność technologiczna witryny ma bezpośredni wpływ na to, jak postrzega ją Google. Jeśli każda podstrona ładuje się kilka sekund, robot zdąży pobrać ich znacznie mniej w trakcie jednej sesji. Optymalizacja czasu odpowiedzi serwera (TTFB) oraz wdrożenie nowoczesnych formatów kompresji danych to nie tylko ukłon w kierunku użytkownika, lecz przede wszystkim realne zwiększenie limitu skanowania. Stąd też inwestycja w szybki hosting oraz odpowiedni kod strony to jeden z najskuteczniejszych sposobów na to, jak zoptymalizować crawl budget.
Crawl budget SEO w branży e-commerce
Sklepy internetowe należą do specyficznego środowiska, w którym zarządzanie zasobami indeksowania stanowi spore wyzwanie. Główną trudnością jest nawigacja fasetowa, czyli popularne filtry (cena, kolor, rozmiar, marka). Każda kombinacja wybranych czynników tworzy nowy adres URL. Jeśli sklep ma 100 produktów i 10 filtrów, liczba potencjalnych kombinacji może iść w tysiące.
W ramach strategii crawl budget SEO w e-commerce stosuje się zazwyczaj tagi canonical lub blokady w robots.txt dla parametrów, które nie niosą unikalnej wartości wyszukiwawczej. Pozwala to crawlerowi skupić się na głównych kategoriach i stronach produktowych, które mają realną szansę przyciągnąć klienta z wyszukiwarki. Bez tych działań sklep może cierpieć na chroniczny brak aktualności cen lub stanów magazynowych w wynikach Google.
Monitorowanie efektów w Google Search Console
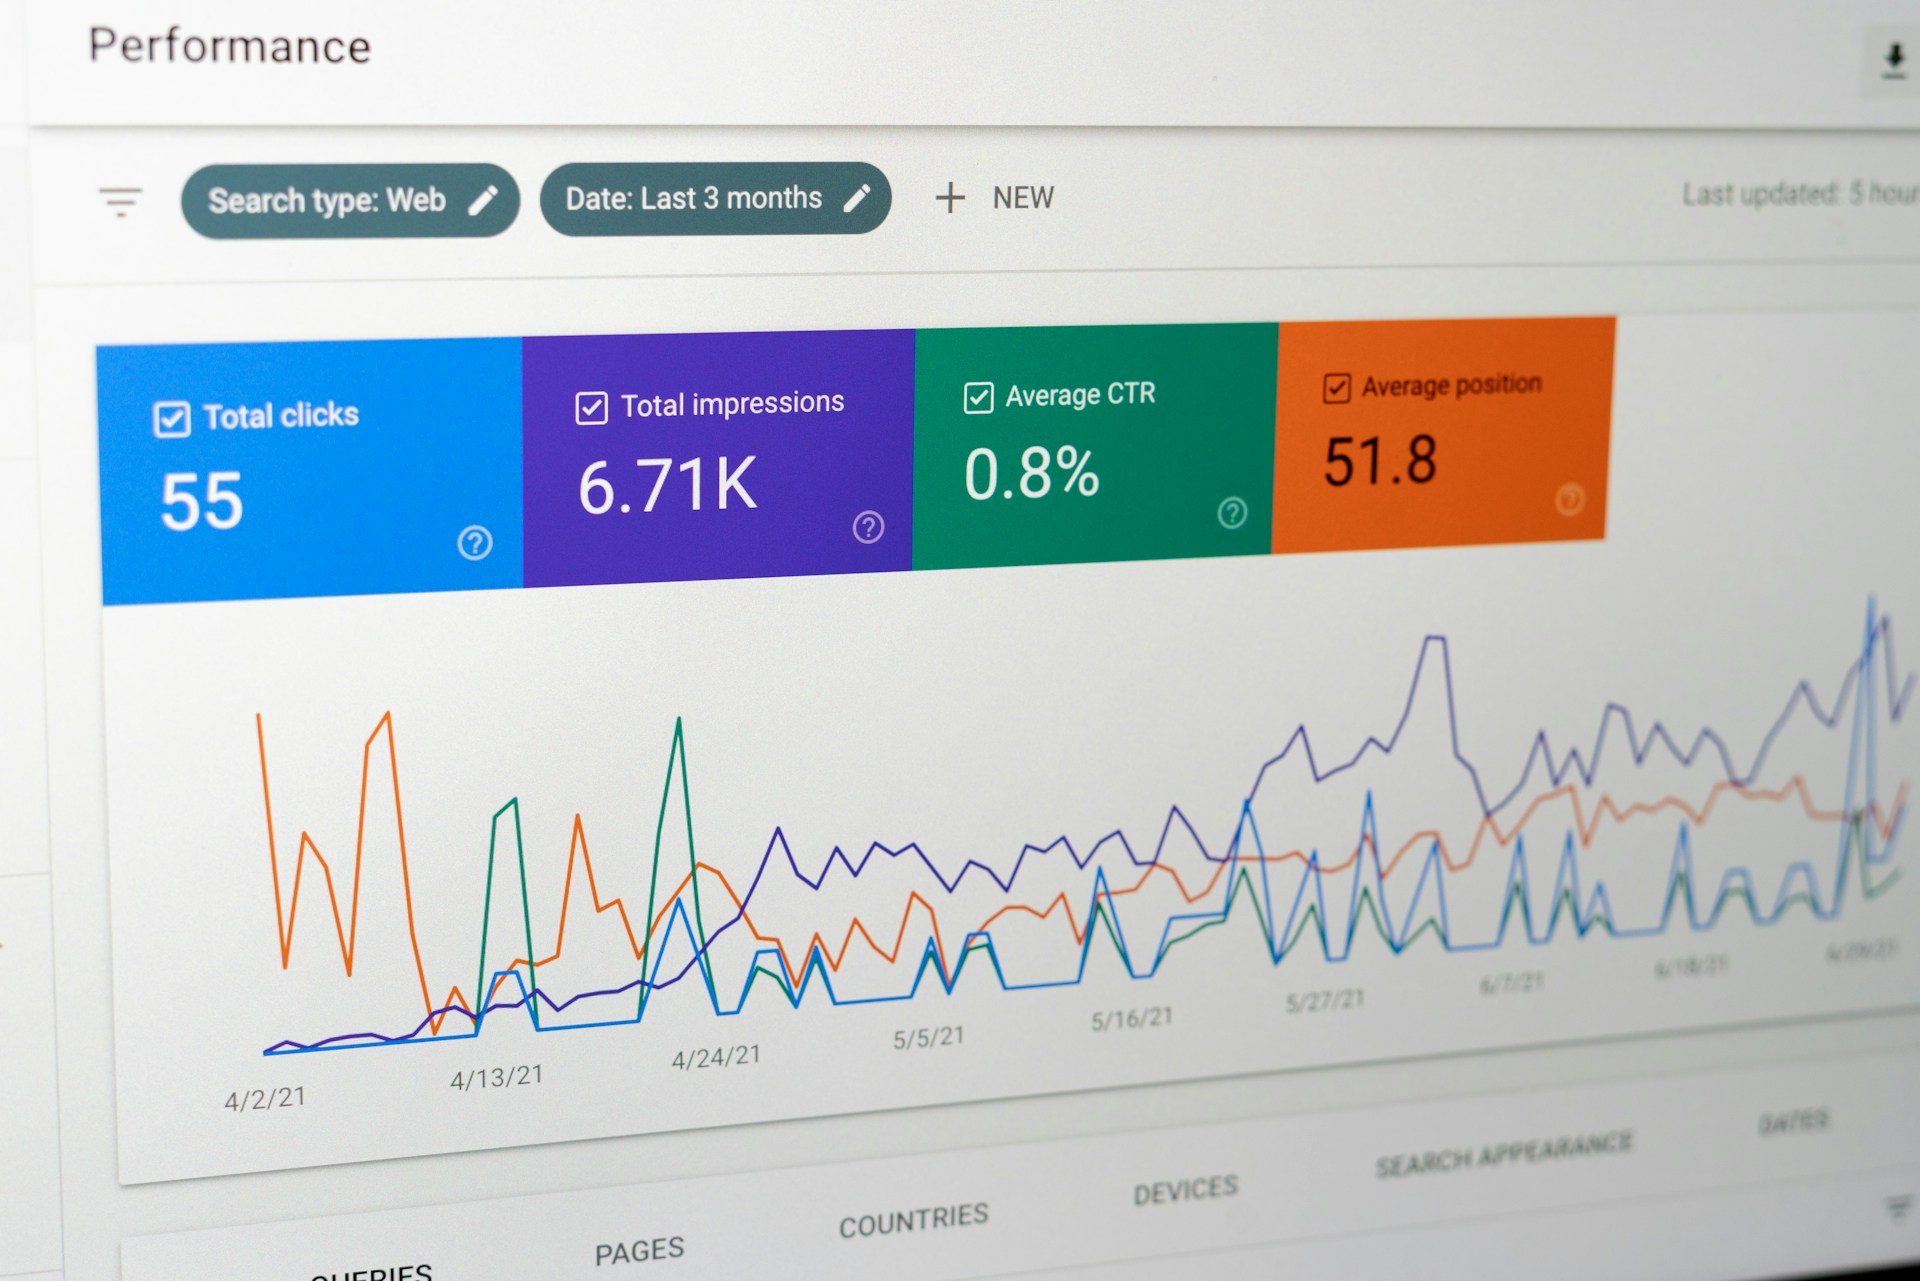
Nie da się zarządzać czymś, czego nie można zmierzyć. Podstawowym narzędziem do analizy tego, jak Google wykorzystuje Twój budżet, jest raport „Statystyki indeksowania” w Google Search Console. Można tam sprawdzić m.in.:
- ile żądań dziennie wykonuje robot,
- jaki jest średni czas odpowiedzi serwera,
- jakie typy plików (HTML, obrazy, skrypty) dominują w procesie skanowania.
Analiza tych danych pozwala wykryć anomalie. Przykładowo, jeśli nagle zauważysz gwałtowny wzrost liczby pobieranych obrazów kosztem plików HTML, może to oznaczać problem z optymalizacją multimediów. Regularne sprawdzanie tego raportu to obowiązek każdego specjalisty dbającego o to, by potencjał strony nie był marnowany na nieistotne elementy.
Podsumowanie: Efektywne zarządzanie zasobami jako klucz do sukcesu
Dbanie o budżet indeksowania to jeden z najbardziej zaawansowanych, a zarazem najbardziej opłacalnych aspektów pozycjonowania. Zrozumienie istoty procesu crawl budget, co to takiego oraz jak wpływa na widoczność, pozwala uniknąć wielu frustracji związanych z powolnym pojawianiem się zmian w Google. Warto jednak mieć na uwadze, że optymalizacja tego obszaru to proces ciągły. Wraz z rozwojem serwisu, dodawaniem nowych sekcji czy produktów, Twoja mapa „priorytetów” dla robota musi być aktualizowana.
A jeżeli planujesz oddać SEO w ręce specjalistów, to zachęcamy do kontaktu z nami!


Skontaktuj się z nami
Wypełnij i wyślij formularz, a odpowiemy w ciągu 24 godzin. Pomożemy w dobraniu optymalnego zakresu działań, aby Twój biznes mógł rosnąć!
